Anonimizacja w BIP polega na trwałym usunięciu z publikowanych dokumentów danych osobowych, które nie są potrzebne do celu jawności: PESEL, prywatnych adresów, telefonów, podpisów. W 2026 roku temat wraca z dwóch powodów naraz. Po pierwsze, podmioty prowadzące BIP trafiły do planu kontroli sektorowych UODO właśnie w zakresie anonimizacji. Po drugie, urzędnicy coraz częściej sięgają po narzędzia AI do streszczania i redagowania pism, a to otwiera zupełnie nowe ryzyko dla danych osobowych.
Ten tekst pokazuje jedno i drugie: jak prawidłowo anonimizować dokumenty przed publikacją oraz jak nie ujawnić danych, gdy dokument urzędowy ma przejść przez ChatGPT lub inny model.
To nie jest porada prawna, lecz praktyczny przewodnik operacyjny. W sprawach spornych skonsultuj się z IOD lub radcą prawnym swojej jednostki.
Anonimizacja w BIP a nowe ryzyko: dokumenty trafiają do AI
Klasyczne poradniki o anonimizacji w BIP kończą się na pytaniu „co zamazać przed publikacją”. Tymczasem w 2026 roku doszedł nowy etap, którego wcześniej nie było: zanim dokument trafi do biuletynu, ktoś często wrzuca go do modelu AI, żeby skrócić uzasadnienie, przeredagować pismo albo wyciągnąć wnioski.
I tu pojawia się problem. Wklejenie dokumentu z danymi osobowymi do ChatGPT to przekazanie tych danych podmiotowi zewnętrznemu, najczęściej na serwery poza Twoją kontrolą. W rozumieniu RODO jest to przetwarzanie, które wymaga podstawy prawnej i zabezpieczeń. Dla urzędu oznacza to prostą zasadę: dane osobowe nie mogą trafić do zewnętrznego modelu bez wcześniejszego zabezpieczenia. Do tego wrócimy w sekcji o ChatGPT.
Co naprawdę znaczy „nieodwracalna” anonimizacja
Najważniejsza zasada brzmi: anonimizacja w BIP ma być nieodwracalna. To odróżnia ją od pseudonimizacji, którą da się cofnąć. Publikujesz wersję, z której danych nie da się odtworzyć, a nie taką, która jedynie je przykrywa.
Stąd bierze się najczęstszy błąd, czyli zakrycie danych czarnym prostokątem w edytorze PDF. Tekst zwykle nadal istnieje pod spodem i da się go skopiować albo odzyskać. Drugim cichym źródłem wycieku są metadane: pliki Word i PDF przechowują autora, komentarze, historię zmian i ukryty tekst, których w biuletynie nie widać, ale można je wyciągnąć. Dlatego anonimizacja to nie zasłonięcie, lecz trwałe usunięcie danych razem z metadanymi, a następnie zapis do nowego pliku.
Punktem wyjścia jest zasada minimalizacji z art. 5 RODO: publikujesz tylko to, co potrzebne do jawności działania organu, a nie całą zawartość teczki.
Jakie dane usunąć przed publikacją w BIP
Najczęściej nadmiarowe wobec celu jawności, a ryzykowne, są:
- PESEL, numery dokumentów tożsamości, NIP osób fizycznych, pełne adresy zamieszkania
- podpisy odręczne i pieczęcie z dodatkowymi danymi
- prywatne telefony i prywatne e-maile (dane służbowe zwykle zostają)
- dane dzieci, rodziców, uczestników, listy obecności
- informacje o zdrowiu i sytuacji rodzinnej, częste w protokołach i nagraniach
- dane stron prywatnych w załącznikach do uchwał i zarządzeń
Anonimizacja nie dotyczy wyłącznie PDF. Protokoły, nagrania, a zwłaszcza arkusze kalkulacyjne (rejestry, zestawienia, listy w XLSX i CSV) bywają źródłem wycieków równie często.
Najczęstsze błędy i jak ich uniknąć
Zamiast kolejnej checklisty, zestawienie błędów, które realnie kończą się publikacją danych w BIP:
| Błąd | Co się dzieje | Jak zapobiec |
|---|---|---|
| Czarny prostokąt na PDF | Tekst zostaje pod nakładką i da się go skopiować | Trwałe usunięcie danych i eksport do nowego pliku |
| Pominięte metadane | Autor, komentarze i historia zmian wyciekają z plikiem | Wyczyść metadane przed publikacją |
| Publikacja „całej teczki” | Dane nadmiarowe zostają w sieci na lata | Minimalizacja: publikuj tylko dane potrzebne do jawności |
| Skan bez sprawdzenia OCR | Ukryta warstwa tekstu nadal zawiera dane | Sprawdź i usuń warstwę OCR, zweryfikuj „na czysto” |
| Brak weryfikacji | Błąd autora nikt nie wychwytuje | Druga osoba sprawdza plik przed publikacją |
Ostatni wiersz jest niedoceniany: przy większej liczbie dokumentów najwięcej daje to, że plik przed publikacją przegląda druga osoba. Trzydzieści sekund „drugiej pary oczu” wyłapuje to, czego autor już nie widzi.
Anonimizacja skanów i PDF (OCR)
Skany są najtrudniejsze, bo dane są zapisane w obrazie, a pod spodem często kryje się warstwa tekstowa z OCR. Sama nakładka graficzna nie wystarczy. W praktyce, krok po kroku w instrukcji anonimizacji skanów: zidentyfikuj dane w całym dokumencie razem z nagłówkami i załącznikami, usuń je trwale, sprawdź i wyczyść warstwę OCR oraz metadane, a na końcu wyeksportuj do nowego pliku i zweryfikuj, czy nazwiska i numery nie dają się już wyszukać ani skopiować.
To etap, na którym ręczne zamazywanie zawodzi najczęściej, bo łatwo przeoczyć jedną daną. Im gęstszy dokument, tym mocniejszy argument za automatycznym wykrywaniem danych.
Anonimizacja w zamówieniach publicznych i przetargach
Obszar, który większość poradników BIP pomija. Dokumentacja postępowań (oferty, protokoły z otwarcia, umowy z wykonawcami, korespondencja) trafia do publikacji i na wnioski o dostęp do informacji publicznej, a zawiera dane osób reprezentujących wykonawców, podpisy, numery kont, czasem dane wrażliwe z dokumentów potwierdzających warunki. Zasada jest ta sama: jawna procedura i rozstrzygnięcie tak, dane osobowe osób prywatnych nie. Anonimizujesz dane w ofertach i załącznikach, numery rachunków, prywatne kontakty i podpisy, a treść merytoryczną i uzasadnienie wyboru zostawiasz jawne.
Trzy tryby redakcji danych w Anonimizerze
W zależności od tego, czy dokument idzie do publikacji, czy do dalszej pracy, potrzebujesz innego trybu. Anonimizer obsługuje trzy:
- Anonimizacja (zaczernianie) to trwałe, nieodwracalne usunięcie danych. Program usuwa przy tym również metadane z plików, co jest kluczowe przy publikacji w BIP. Ostateczna odpowiedzialność za opublikowany dokument zawsze pozostaje po stronie osoby publikującej.
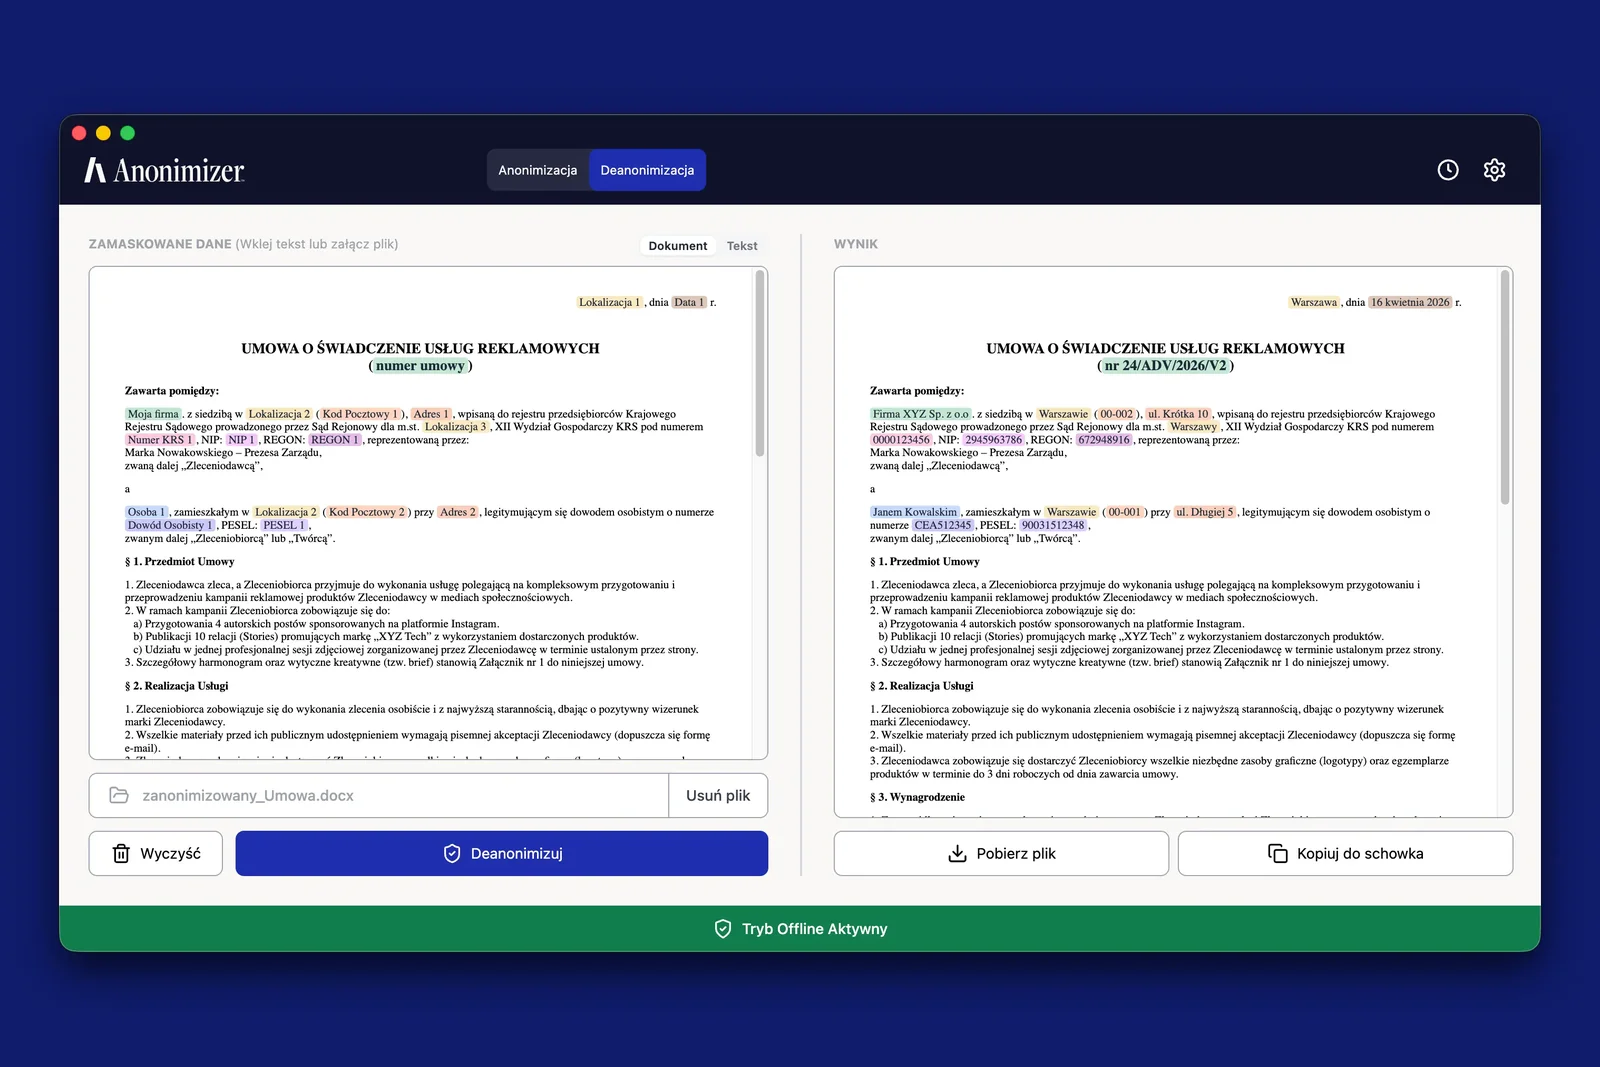
- Pseudonimizacja przez neutralne znaczniki zastępuje dane oryginalne tokenami (np. [IMIĘ_1], [PESEL_1]).
- Pseudonimizacja przez dane fikcyjne zastępuje je prawdopodobnie wyglądającymi, lecz nieprawdziwymi wartościami.
W obu trybach pseudonimizacji dane można później przywrócić lokalnie, na komputerze użytkownika, na przykład po zakończeniu pracy z modelem AI. Do publikacji w BIP wybierasz anonimizację nieodwracalną; pseudonimizacja jest po to, by dokument wrócił do Ciebie z oryginalnymi danymi po przejściu przez narzędzie zewnętrzne.
Czy urząd może użyć ChatGPT do dokumentu z BIP?
Tak, ale nie wolno wysyłać do modelu danych osobowych w postaci jawnej. Jeśli wrzucisz do ChatGPT projekt uchwały albo protokół z nazwiskami i adresami, przekazujesz te dane firmie zewnętrznej, zwykle na serwery poza Twoją kontrolą. To przetwarzanie w rozumieniu RODO i realne ryzyko naruszenia.
Bezpieczny obieg wygląda inaczej. Najpierw pseudonimizujesz dokument lokalnie, czyli zastępujesz dane tokenami albo wartościami fikcyjnymi. Pracujesz z AI na bezpiecznej wersji, w której nie ma żadnych prawdziwych danych. Na końcu przywracasz dane lokalnie, u siebie na komputerze. Do samej publikacji w biuletynie używasz już anonimizacji nieodwracalnej. Dzięki temu korzystasz z wygody modelu, a żadna prawdziwa dana nie opuszcza urzędu.
Automatyczne wykrywanie danych zamiast ręcznego zamazywania
Ręczne przeszukiwanie dokumentu w poszukiwaniu wszystkich danych do usunięcia jest wolne i zawodne. Narzędzie, które samo rozpoznaje typy danych i zastępuje je w całym dokumencie, zamienia tę pracę w kilka sekund i ogranicza błąd ludzki.
Anonimizer rozpoznaje 25 typów polskich danych osobowych (PESEL, NIP, KRS, imiona, nazwiska, adresy, e-maile i inne). Co istotne dla sektora publicznego, przetwarzanie odbywa się w całości lokalnie, na komputerze urzędnika, więc żaden dokument nie jest wysyłany do chmury. Obsługiwane formaty obejmują PDF, DOCX, DOC, ODT, RTF, PPTX, XLSX, XLS, ODS i CSV, czyli również arkusze, w których danych jest zwykle najwięcej, a także skany i zdjęcia.
Kontrole UODO a BIP w 2026
W styczniu 2026 r. UODO wskazał podmioty prowadzące BIP w planie kontroli sektorowych, w zakresie anonimizacji danych i udostępniania przebiegu sesji. Zanim kontrola stanie się tematem, warto mieć spisaną procedurę anonimizacji, rejestr publikacji oraz ustalony standard techniczny (nieodwracalność, czyszczenie metadanych, eksport do nowego pliku). To minimum, które zwykle wystarcza, by uniknąć problemu tam, gdzie można mieć spokój.
FAQ
Czym anonimizacja w BIP różni się od pseudonimizacji?
Anonimizacja jest nieodwracalna i służy publikacji. Pseudonimizacja jest odwracalna i sprawdza się przy pracy wewnętrznej oraz z narzędziami AI, gdy dane mają wrócić do Ciebie.
Czy mogę użyć ChatGPT do dokumentu, który trafi do BIP?
Tak, ale dopiero po pseudonimizacji lub anonimizacji. Dane osobowe w postaci jawnej nie mogą trafić do zewnętrznego modelu.
Czy dane można przywrócić po anonimizacji?
Po anonimizacji nie, bo jest nieodwracalna. Po pseudonimizacji tak, lokalnie na Twoim komputerze.
Czy trzeba anonimizować arkusze XLSX i pliki CSV w BIP?
Tak. Rejestry i zestawienia często zawierają najwięcej danych osobowych i podlegają tym samym zasadom co PDF.
Czy skan PDF można opublikować w BIP?
Tak, po trwałej anonimizacji i sprawdzeniu warstwy OCR oraz metadanych.
Podsumowanie
W 2026 roku anonimizacja w BIP ma dwa wymiary. Pierwszy to klasyka: trwałe, nieodwracalne usunięcie danych nadmiarowych razem z metadanymi, zanim dokument trafi do publikacji. Drugi jest nowy: jeśli po drodze korzystasz z AI, dane muszą zostać zabezpieczone, zanim opuszczą urząd, a wrócić do Ciebie dopiero po pracy z modelem. Lokalne narzędzie, które automatycznie wykrywa dane i pozwala je trwale usunąć lub odwracalnie zamaskować, ogarnia oba przypadki bez wysyłania czegokolwiek na zewnątrz.
Anonimizuj i pseudonimizuj dokumenty lokalnie, na swoim komputerze. Pobierz Anonimizer za darmo: 5 dokumentów miesięcznie w planie darmowym, a większe wdrożenia w urzędzie obejmuje oferta dla instytucji.
Źródła
- UODO, Plan kontroli sektorowych na 2026 r. (BIP, anonimizacja): https://uodo.gov.pl/pl/138/4029
- RODO (rozporządzenie 2016/679): art. 4 pkt 5 (pseudonimizacja), art. 5 (minimalizacja), motyw 26 (anonimizacja): https://eur-lex.europa.eu
- Ustawa o dostępie do informacji publicznej: https://isap.sejm.gov.pl
- Anonimizer, bezpieczeństwo i lokalne przetwarzanie danych: https://anonimizer.pl/bezpieczenstwo/