Deanonimizacja to potoczna nazwa przywrócenia prawdziwych danych w tekście, w którym wcześniej zastąpiono je etykietami. W języku RODO mówimy w takim przypadku o odwróceniu pseudonimizacji. Tam, gdzie w odpowiedzi ChatGPT znajduje się [OSOBA_1], po przywróceniu danych znów pojawia się „Jan Kowalski”. Proces jest bezpieczny, gdy mapa łącząca etykiety z prawdziwymi wartościami nie opuszcza komputera użytkownika.
W Anonimizerze mapa pozostaje lokalnie. Po zakończeniu pracy z AI wystarczy wkleić odpowiedź i wybrać Deanonimizuj, aby przywrócić dane.
Czym jest deanonimizacja i dlaczego przydaje się przy pracy z AI
Usunięcie danych identyfikujących przed wysłaniem dokumentu do AI to pierwszy etap. Model może otrzymać tekst bez nazwisk, numerów PESEL, adresów czy innych oznaczonych informacji, dzięki czemu ograniczasz zakres danych przekazywanych zewnętrznemu dostawcy.
Odpowiedź wraca jednak w podobnej postaci. Projekt pisma procesowego, streszczenie akt czy tłumaczenie umowy nadal zawiera etykiety [OSOBA_1], [OSOBA_2] czy [PESEL_1]. Takiego dokumentu nie wyślesz klientowi ani nie złożysz w urzędzie.
Można oczywiście podmienić wszystko ręcznie. Przy kilkunastostronicowym dokumencie zajmuje to jednak czas i łatwo o pomyłkę. Wystarczy zamienić miejscami dwie osoby, żeby powód stał się pozwanym.
Dlatego ostatnim etapem pracy jest przywrócenie danych. Anonimizer robi to automatycznie na podstawie mapy utworzonej podczas wcześniejszego maskowania dokumentu.
Zagrożenie i funkcja: dwa znaczenia słowa „deanonimizacja”
Hasło „deanonimizacja” może opisywać dwa różne zjawiska.
Pierwsze to zagrożenie, często określane jako reidentyfikacja. Ktoś otrzymuje zbiór danych pozbawiony bezpośrednich identyfikatorów, a następnie ustala, kogo dotyczy, zestawiając informacje takie jak data urodzenia, kod pocztowy, stanowisko czy opis konkretnego zdarzenia.
Drugie znaczenie jest czysto funkcjonalne: osoba, która wcześniej ukryła dane i ma dostęp do mapy powiązań, świadomie przywraca je do dokumentu. Właśnie tego znaczenia dotyczy ten artykuł.
Czy deanonimizacja to pojęcie prawne?
Nie. Słowa „deanonimizacja” nie znajdziemy w RODO ani w polskiej ustawie o ochronie danych osobowych. To określenie potoczne, które przeszło do praktyki z języka technicznego.
Z punktu widzenia RODO ważne jest inne rozróżnienie. O anonimizacji można mówić wtedy, gdy osoby nie da się już zidentyfikować przy użyciu środków, których wykorzystania można rozsądnie oczekiwać. Jeżeli natomiast istnieją dodatkowe informacje pozwalające ponownie przypisać dane konkretnej osobie, mamy do czynienia z pseudonimizacją.
Pseudonimizację definiuje art. 4 pkt 5 RODO. Dane po pseudonimizacji nie mogą zostać przypisane konkretnej osobie bez użycia dodatkowych informacji, które są przechowywane osobno i odpowiednio chronione. W Anonimizerze taką dodatkową informacją jest mapa powiązań.
RODO odnosi się również do ryzyka nieuprawnionego odwrócenia pseudonimizacji (motywy 75 i 85). W praktyce oznacza to, że sama możliwość przywrócenia danych nie jest problemem. Znaczenie ma to, kto ma dostęp do informacji pozwalających je przywrócić i w jaki sposób są one zabezpieczone.
W samej aplikacji funkcja ta nosi nazwę Przywracanie danych. W tym artykule używamy również potocznego określenia „deanonimizacja”, bo pod taką nazwą ten proces funkcjonuje w praktyce.
Różnicę między anonimizacją a pseudonimizacją opisujemy szerzej w przewodniku ChatGPT i RODO.
Jak działa pseudonimizacja: co widzi AI, a co zostaje u Ciebie
Praca z Anonimizerem może wyglądać w pięciu krokach:
- Dokument źródłowy. Umowa, pismo albo arkusz zawiera prawdziwe dane i znajduje się na Twoim komputerze.
- Anonimizacja lokalna. Aplikacja wykrywa dane i zastępuje je etykietami:
Jan Kowalskistaje się[OSOBA_1], a numer PESEL[PESEL_1]. Ta sama osoba w całym dokumencie otrzymuje tę samą etykietę. Równolegle powstaje mapa powiązań etykieta → wartość. - Model AI. Do ChatGPT, Claude, Gemini czy Copilota trafia tekst z etykietami zamiast oznaczonych danych. Model może pracować na strukturze i treści dokumentu bez otrzymywania bezpośrednich identyfikatorów ukrytych pod tymi etykietami.
- Odpowiedź. Model zwraca wynik z tymi samymi oznaczeniami.
- Przywracanie danych. Odpowiedź trafia z powrotem do Anonimizera, który na podstawie lokalnej mapy wstawia właściwe wartości.
Mapa powiązań nie trafia w tym procesie ani do dostawcy AI, ani do producenta aplikacji. Treść dokumentu i operacje na danych wykonywane są lokalnie. Więcej opisujemy na stronie bezpieczeństwo danych oraz w sekcji jak działa Anonimizer.
Jak przywrócić dane po pseudonimizacji: krok po kroku w Anonimizerze
- Zanonimizuj dokument w trybie Etykieta i wklej wynik do wybranego narzędzia AI.
- W poleceniu warto dodać zdanie: „Nie zmieniaj etykiet w nawiasach kwadratowych”. Jest to szczególnie przydatne przy tłumaczeniach, ponieważ model może próbować zmienić
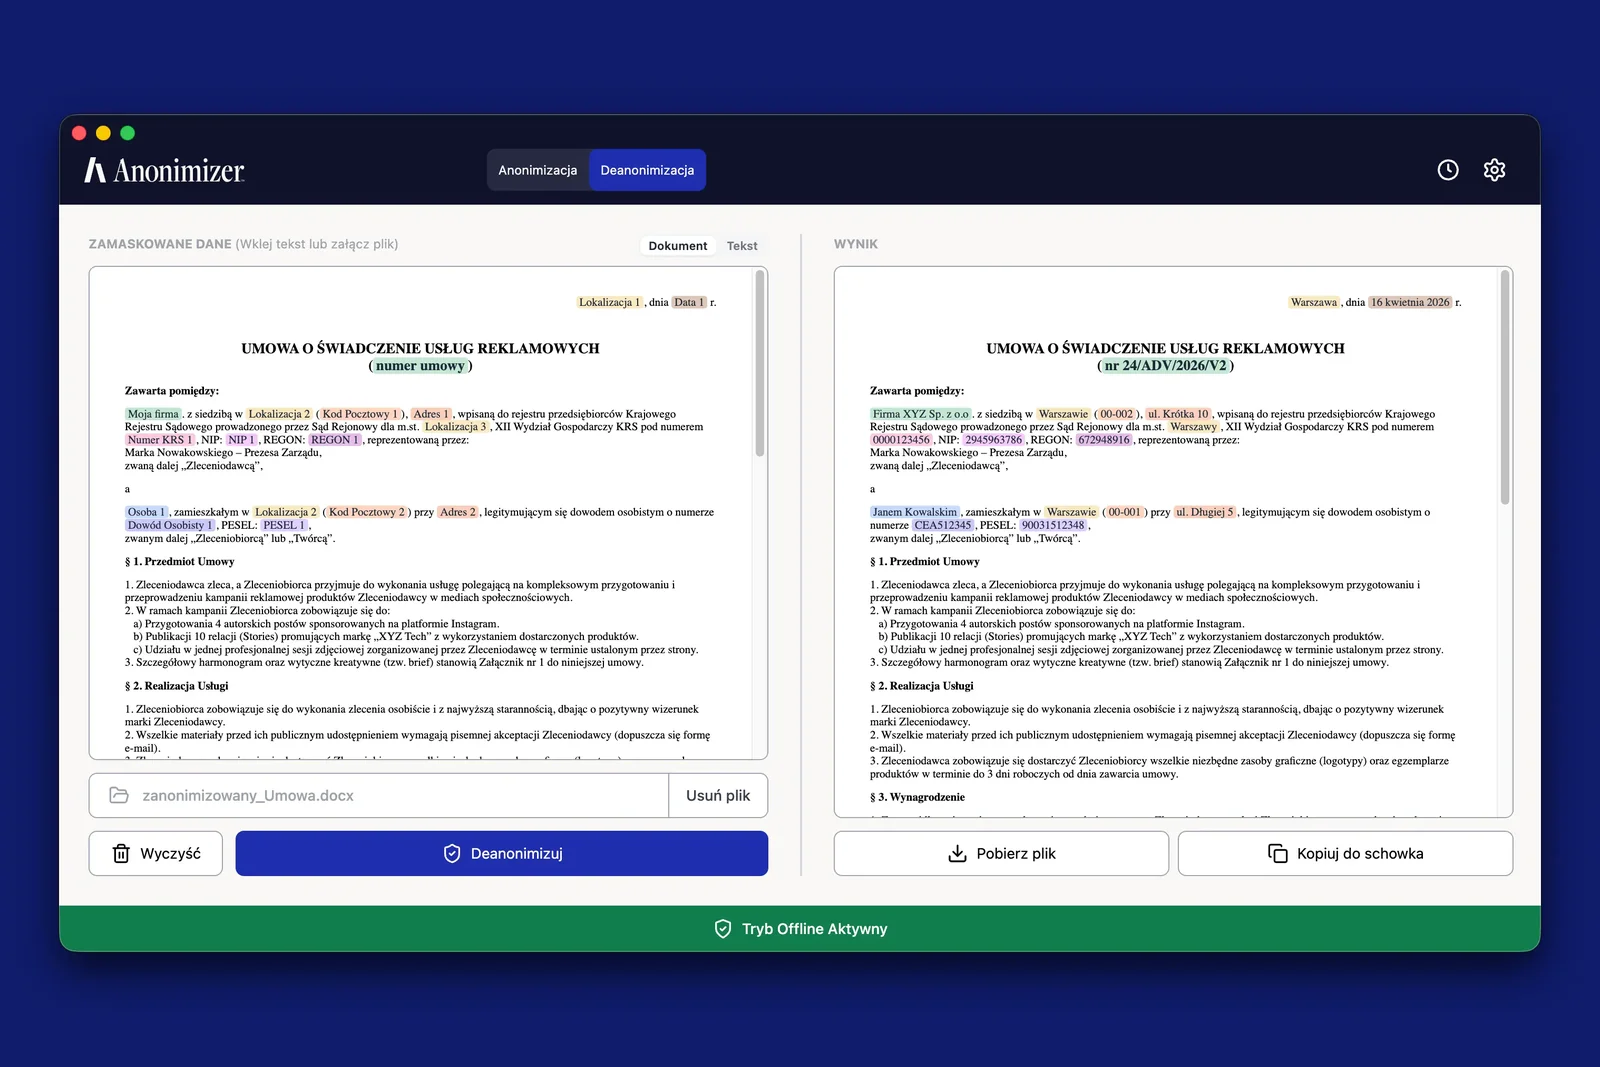
[OSOBA_1]na przykład na[PERSON_1]. Zmienionej etykiety aplikacja może nie rozpoznać. - Skopiuj odpowiedź AI i otwórz zakładkę Przywracanie danych (we wcześniejszych wersjach aplikacji: Deanonimizacja).
- Wklej tekst do panelu Zamaskowane dane. Możesz również przeciągnąć plik albo skorzystać z przycisku Wybierz plik.
- Kliknij Deanonimizuj. W panelu Wynik pojawi się tekst z przywróconymi wartościami.
- Skopiuj wynik do schowka albo pobierz go jako plik DOCX, TXT lub MD.
Przywrócone wartości są podświetlone kolorem odpowiadającym danej kategorii. Po najechaniu kursorem można sprawdzić, pod jaką etykietą znajdowała się konkretna wartość.
Dane można przywrócić także wtedy, gdy tekst wokół etykiet został wcześniej zmieniony przez model AI albo przez użytkownika. Pełny opis funkcji, w tym przywracania danych z historii, znajdziesz w instrukcji przywracania danych.
Możesz też sprawdzić cały proces na własnym dokumencie: pobierz Anonimizer.
Kiedy deanonimizacja jest bezpieczna, a kiedy trzeba uważać
Najważniejsze pytanie brzmi: gdzie przechowywana jest mapa pozwalająca przywrócić dane?
Mapa lokalna. W Anonimizerze powstaje i pozostaje na komputerze użytkownika. Dostawca AI otrzymuje dokument z etykietami, natomiast mapa jest przechowywana lokalnie w zaszyfrowanej bazie. Z serwerem aplikacja wymienia informacje potrzebne do obsługi licencji i aktualizacji, ale nie wysyła treści dokumentów.
Mapa u zewnętrznego dostawcy. Jeśli pseudonimizacja odbywa się w usłudze online, jej operator może mieć dostęp zarówno do dokumentu wejściowego, jak i informacji potrzebnych do jego przetworzenia. W takim modelu znaczenie mają m.in. zabezpieczenia dostawcy, zawarte umowy i miejsce przetwarzania danych.
Jest jeszcze trzeci element: sam kontekst.
Etykieta nie rozwiąże problemu, jeżeli pozostała część tekstu pozwala łatwo wskazać konkretną osobę. Zdanie „[OSOBA_1], prezes jedynej spółdzielni mleczarskiej w gminie” może nadal prowadzić do identyfikacji. Dlatego przed wysłaniem dokumentu warto przejrzeć wynik i usunąć również zbędne szczegóły kontekstowe.
Pseudonimizacja a zmiany w RODO
Obecnie pseudonimizacja nie oznacza automatycznie, że informacje przestają być danymi osobowymi. Jeżeli organizacja posiada mapę pozwalającą ponownie przypisać dane konkretnej osobie, z jej perspektywy nadal mamy do czynienia z danymi osobowymi.
Jednocześnie w europejskiej dyskusji prawnej coraz większe znaczenie ma perspektywa konkretnego odbiorcy: czy podmiot, który otrzymuje dane spseudonimizowane, rzeczywiście dysponuje środkami pozwalającymi ustalić tożsamość osoby.
W wyroku z 4 września 2025 r. w sprawie C-413/23 P TSUE wskazał, że ocena charakteru danych może zależeć również od realnych możliwości identyfikacji po stronie konkretnego odbiorcy.
Podobny kierunek pojawia się w projektowanych zmianach do RODO w ramach pakietu Digital Omnibus, negocjowanego obecnie w Radzie UE. Dyskutowany jest tam nowy art. 25a dotyczący danych spseudonimizowanych. Projekt zastrzega przy tym, że dla podmiotu przetwarzającego dane w imieniu administratora pozostają one danymi osobowymi. To nadal proces legislacyjny, dlatego ostateczny kształt przepisów może się zmienić.
Z praktycznego punktu widzenia najważniejsza pozostaje kontrola nad dodatkowymi informacjami pozwalającymi odwrócić pseudonimizację. W Anonimizerze mapa pozostaje po stronie osoby lub organizacji, która przygotowała dokument.
W praktyce: pismo procesowe, wniosek do urzędu, dokumentacja medyczna
Pismo procesowe. Pełnomocnik przygotowuje odpowiedź na pozew. AI porządkuje stan faktyczny z akt sprawy, zestawia twierdzenia powoda z dowodami i proponuje strukturę argumentacji. Model pracuje na etykietach: [OSOBA_1] to powód, [OSOBA_2] pozwany, [OSOBA_3] świadek, a w razie potrzeby zamaskowane są także kwoty i sygnatura akt. Po przywróceniu danych projekt pisma zawiera właściwe strony, świadków i oznaczenia sprawy. Weryfikacja merytoryczna i podpis pozostają oczywiście po stronie pełnomocnika. Więcej o pracy kancelarii z AI piszemy w artykule o AI w kancelarii prawnej.
Wniosek do urzędu. Biuro rachunkowe przygotowuje dla klienta wniosek do urzędu skarbowego o rozłożenie zaległości na raty. AI tworzy szkic, w którym zamiast podatnika znajduje się [OSOBA_1], a zamiast numeru NIP [NIP_1]. Po przywróceniu danych dokument można dalej sprawdzić i przygotować do podpisu.
Dokumentacja medyczna. Tutaj ostrożność powinna być szczególnie duża. Dane o zdrowiu należą do szczególnych kategorii danych z art. 9 RODO, a kombinacja takich informacji jak rzadka choroba, wiek, stanowisko czy miejscowość może pozwolić na identyfikację pacjenta mimo usunięcia nazwiska. AI może na przykład pomóc przełożyć zalecenia po wypisie na prostszy język, ale przed wysłaniem materiału warto ograniczyć jego treść do informacji rzeczywiście potrzebnych do wykonania zadania. Przywrócenie oznaczonych danych może nastąpić później, lokalnie na komputerze placówki.
Czego nie da się przywrócić
Przywracanie danych działa tam, gdzie wcześniej powstała mapa. Anonimizer oferuje trzy sposoby zamiany informacji:
- Etykieta:
[OSOBA_1]zamiast nazwiska. Tryb odwracalny, w praktyce jest to pseudonimizacja. - Fikcyjne dane: realistyczne zamienniki, np. „Piotr Wiśniewski” zamiast „Jan Kowalski”. Mapa również jest zachowywana, dlatego wartości można później przywrócić.
- Zaczernianie: dane są zastępowane ciągiem bloków ████. Ten tryb jest nieodwracalny. Może prowadzić do anonimizacji w rozumieniu RODO, jeżeli również pozostały kontekst dokumentu nie pozwala zidentyfikować osoby.
Nieodwracalne są również zaczernienia wykonywane w widoku dokumentu PDF oraz zamazania na obrazach, np. na skanach lub zdjęciach dokumentów. W pobranym pliku pod maską nie pozostaje ukryta warstwa tekstowa z usuniętą wartością.
Mapy nie można również odtworzyć po trwałym usunięciu sesji z historii aplikacji. Usunięcie wpisu oznacza usunięcie informacji potrzebnych do późniejszego przywrócenia danych.
Praktyczna zasada jest prosta: jeżeli zamierzasz później wrócić do dokumentu z prawdziwymi danymi, wybierz Etykietę. Jeśli celem jest trwałe usunięcie oznaczonych informacji przed udostępnieniem dokumentu na zewnątrz, wybierz Zaczernianie i sprawdź również, czy sama treść nie pozwala zidentyfikować osoby.
FAQ: deanonimizacja dokumentów
Czy AI może odgadnąć dane ukryte pod etykietą?
Z samej etykiety nie. [OSOBA_1] nie zawiera informacji o tym, kim jest dana osoba. Model nie ma również dostępu do lokalnej mapy powiązań.
Znaczenie może mieć jednak kontekst. Jeżeli dokument opisuje osobę na tyle szczegółowo, że da się ją rozpoznać bez znajomości nazwiska, sama zamiana nazwiska na etykietę tego nie zmieni. Dlatego przed wysłaniem dokumentu warto przejrzeć również informacje pośrednie.
Czy klucz do przywrócenia danych jest szyfrowany?
Tak. Historia anonimizacji wraz z mapą potrzebną do przywracania danych jest przechowywana w zaszyfrowanej bazie na komputerze użytkownika. Klucz szyfrujący jest przypisany do urządzenia. Treść dokumentów, wyniki i historia sesji nie są wysyłane na serwer Anonimizera.
Co się stanie, jeśli zamknę aplikację przed deanonimizacją?
Nie musisz od razu przywracać danych. Każda anonimizacja zapisuje się automatycznie w historii. Po ponownym uruchomieniu aplikacji możesz otworzyć Historię, wybrać odpowiednią sesję i przejść do zakładki Przywracanie danych.
Przywrócenie nie będzie możliwe dopiero wtedy, gdy dana sesja zostanie wcześniej usunięta z historii.
Czy deanonimizacja działa dla plików XLSX?
Tak. Arkusze XLSX i ODS można anonimizować z zachowaniem formatowania. Obsługiwane są również pliki XLS i CSV.
Plik zawierający etykiety możesz później wczytać do panelu Zamaskowane dane, przeciągając go do aplikacji albo wybierając przycisk Wybierz plik.
W praktyce AI często zwraca analizę arkusza jako tekst lub tabelę bezpośrednio w odpowiedzi. W takim przypadku wystarczy skopiować wynik i wkleić go do Anonimizera, aby przywrócić oznaczone dane.